최종 인프라 구조 : CloudFront, S3, EC2(Auto Scaling Group), CodeDeploy 의 총집합
2026년 8월 7일
단일 EC2에 pm2로 앱을 띄우던 구조에서 출발해, 지금은 CloudFront와 ALB, Auto Scaling Group, S3, CodeDeploy Blue/Green이 총집합된 구조로 서비스하고 있습니다.
전체 그림
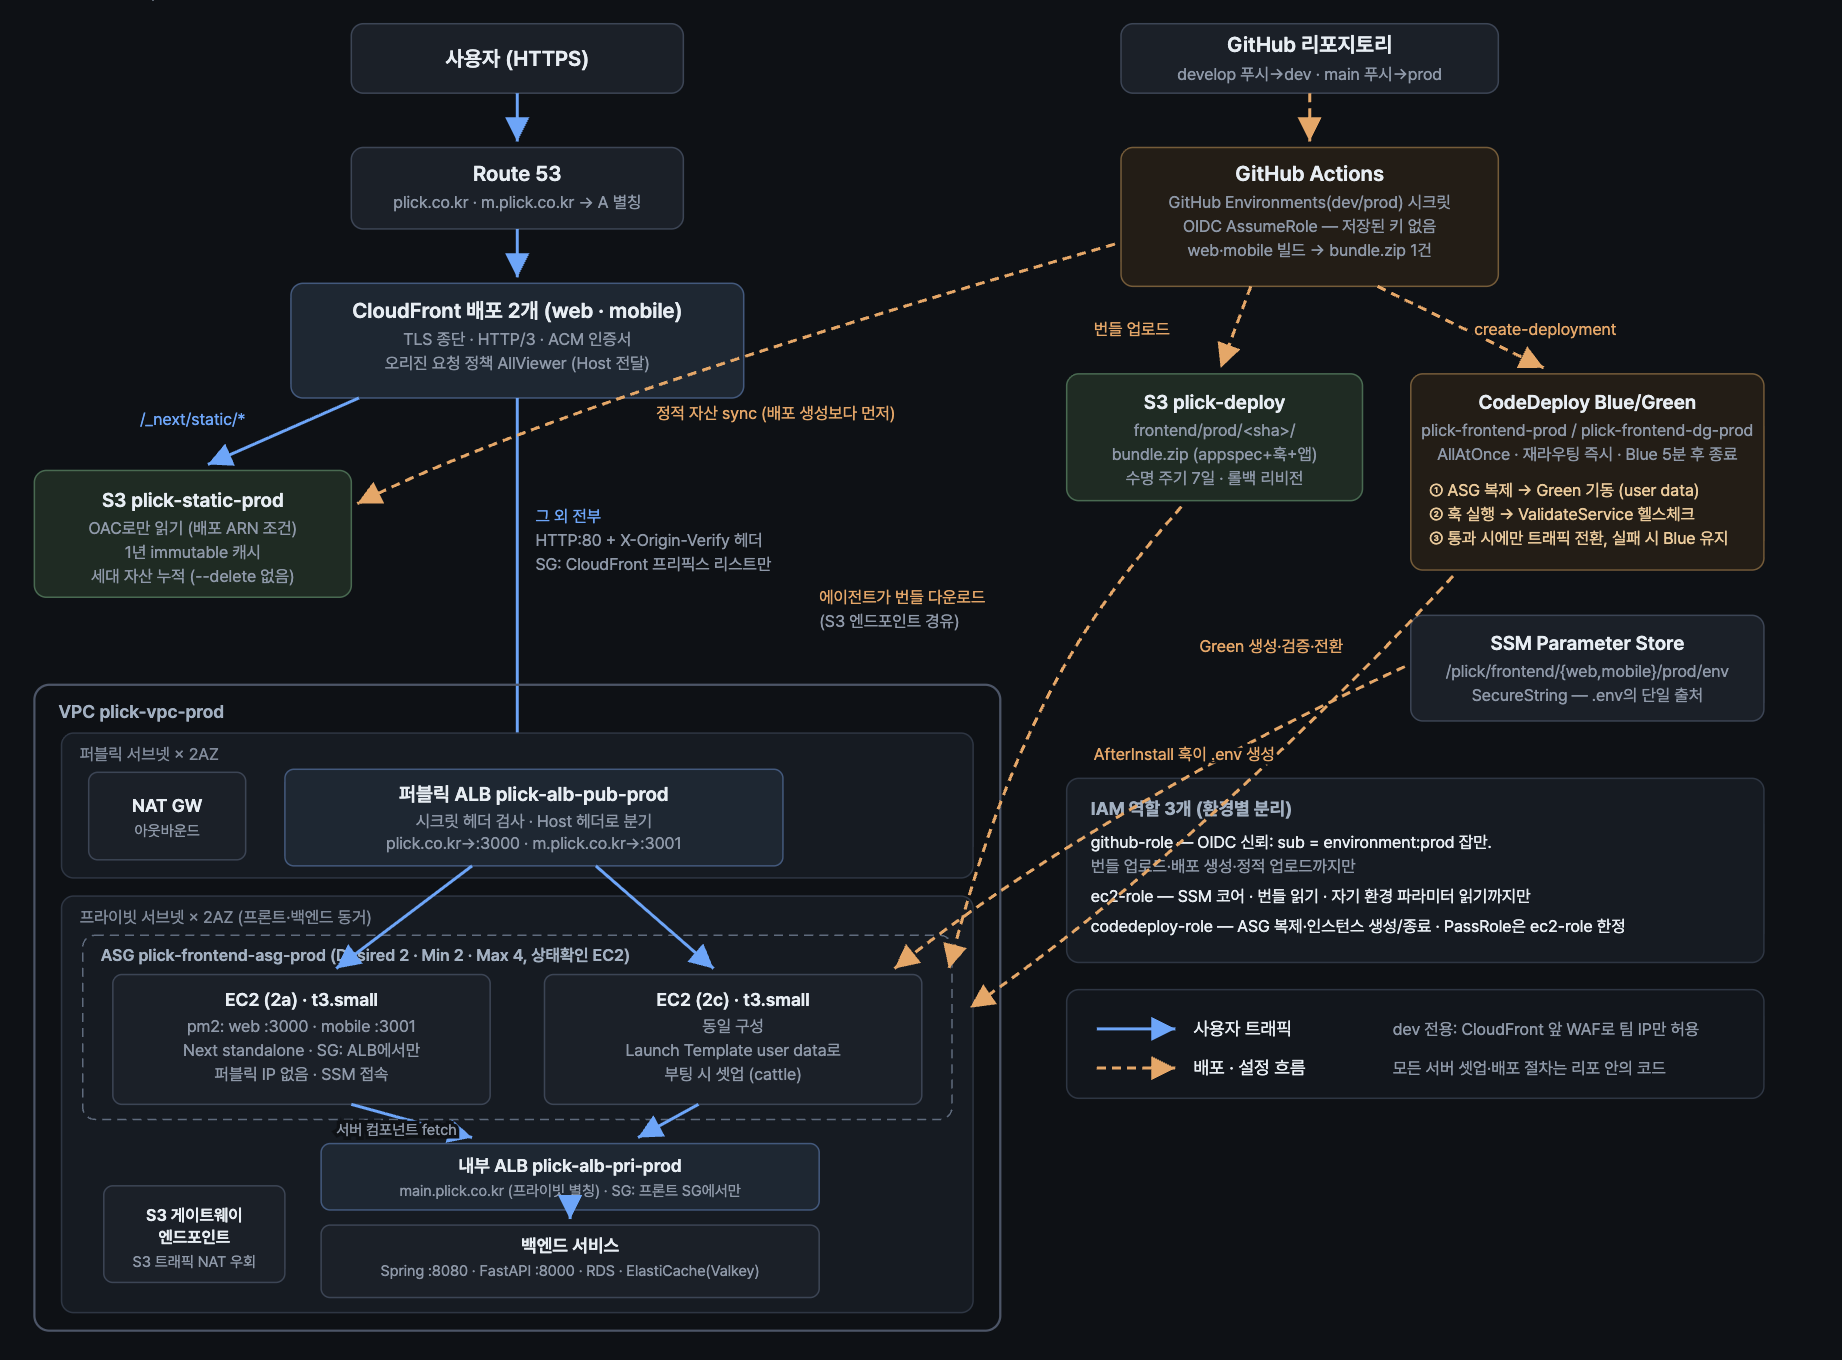
사용자 요청 하나가 화면에 닿기까지의 경로는 이렇습니다.
사용자
  │  HTTPS
  ▼
Route 53 (plick.co.kr, m.plick.co.kr → A 별칭 레코드)
  │
  ▼
CloudFront 배포 2개 (web용, mobile용)
  │  ├─ /_next/static/* ──→ S3 정적 버킷 (plick-static-prod)
  │  └─ 그 외 전부 ──→ HTTP:80 + 시크릿 헤더
  ▼
퍼블릭 ALB (plick-alb-pub-prod)
  │  Host 헤더로 분기: plick.co.kr → :3000, m.plick.co.kr → :3001
  ▼
프라이빗 서브넷의 EC2 (Auto Scaling Group, 2AZ × 2대)
  │  Next.js standalone 서버 2개를 pm2로 구동 (web :3000, mobile :3001)
  │  서버 컴포넌트의 데이터 fetch
  ▼
내부 ALB (plick-alb-pri-prod) ──→ 백엔드 (Spring :8080, FastAPI :8000)
배포는 GitHub Actions가 빌드한 번들을 CodeDeploy가 Blue/Green으로 새 인스턴스 세트에 얹고 트래픽을 넘기는 방식입니다. dev와 prod가 완전히 같은 구조로 두 벌 존재하고, develop 브랜치 푸시는 dev로, main 푸시는 prod로 나갑니다. 이 글은 prod 기준으로 설명하지만 dev도 이름의 접미사만 다르고 동일합니다.
네트워크: 프라이빗 우선 설계
VPC 안에 퍼블릭 서브넷과 프라이빗 서브넷이 각각 두 가용영역(2a, 2c)에 걸쳐 있습니다.
프론트 EC2는 전부 프라이빗 서브넷에 삽니다.
퍼블릭 IP가 아예 없어서 인터넷에서 인스턴스로 직접 접근할 방법이 없고, SSH 포트도 열지 않습니다.
서버 접속이 필요할 때는 SSM Session Manager를 씁니다. 세션 매니저는 인스턴스에 설치된 SSM 에이전트가 AWS 쪽으로 아웃바운드 연결을 맺어 두는 방식이라 인바운드 포트가 하나도 필요 없습니다.
그치만 프라이빗 인스턴스도 나가는 길은 필요합니다.
Node 설치나 npm 레지스트리 접근 같은 아웃바운드 인터넷 트래픽은 NAT 게이트웨이를 거칩니다.
다만 S3로 가는 트래픽만은 S3 게이트웨이 엔드포인트로 따로 빼 두었습니다.
게이트웨이 엔드포인트는 프라이빗 서브넷의 라우팅 테이블에 "S3 대역은 이쪽으로"라는 경로를 추가하는 방식이라, 배포 아티팩트 다운로드 같은 굵은 S3 트래픽이 NAT를 타지 않습니다.
NAT는 처리량 기준으로 과금되므로 비용이 줄고, 트래픽이 AWS 네트워크 밖으로 나갔다 들어오지 않으니 경로도 짧아집니다.
엣지: CloudFront와 정적 자산 분리
도메인당 CloudFront 배포가 하나씩 있습니다. 배포마다 오리진이 두 개입니다.
첫째 오리진은 퍼블릭 ALB입니다.
기본 동작(모든 경로)이 여기로 가며, 캐시 정책은 Managed-CachingDisabled입니다.
HTML은 사용자와 시점마다 달라질 수 있는 동적 응답이라 엣지에서 캐시하지 않고, CloudFront는 TLS 종단과 HTTP/3, 엣지 접속 지연 단축 역할만 맡습니다.
오리진 요청 정책은 Managed-AllViewer로, 뷰어가 보낸 Host 헤더를 오리진까지 그대로 전달합니다.(이게 중요한 이유는 뒤의 ALB 절에서 설명합니다.)
둘째 오리진은 정적 자산 S3 버킷입니다.
/_next/static/* 경로 패턴의 동작이 여기로 가며, 캐시 정책은 Managed-CachingOptimized입니다.
Next.js는 빌드 산출물의 파일명에 콘텐츠 해시를 넣기 때문에 같은 URL의 내용이 바뀔 일이 없고, 그래서 Cache-Control: public,max-age=31536000,immutable로 1년 캐시를 걸어도 안전합니다.
무효화(invalidation)도 필요 없습니다. 내용이 바뀌면 URL 자체가 바뀌기 때문입니다.
정적 자산을 EC2가 아니라 S3에서 서빙하는 데는 성능 외의 이유가 하나 더 있습니다.
Blue/Green 배포 중에는 구세대와 신세대 인스턴스가 잠깐 공존합니다. HTML은 신세대가 주고 정적 자산 요청은 구세대에 떨어지면, 신세대 해시의 청크 파일이 구세대에 없어서 404가 납니다. S3 버킷에는 배포마다 새 자산을 추가만 하고(aws s3 sync에 --delete를 쓰지 않습니다) 구세대 자산을 남겨 두므로, 어느 세대의 HTML이 와도 청크를 찾을 수 있습니다. 세대 간 404 문제가 구조적으로 사라집니다.
S3 버킷은 퍼블릭 액세스를 전부 차단하고, CloudFront의 OAC(Origin Access Control)로만 읽게 했습니다.
버킷 정책이 cloudfront.amazonaws.com 서비스 주체의 GetObject를 허용하되 AWS:SourceArn 조건으로 우리 배포 두 개의 ARN만 받아 줍니다. 버킷 URL을 알아내도 직접 내려받을 수 없습니다.
오리진 보안: CloudFront 뒤의 ALB를 세 겹으로 잠금
퍼블릭 ALB는 인터넷 연결형이라 그대로 두면 CloudFront를 우회해 ALB로 직접 접근할 수 있습니다. 그러면 WAF나 엣지에서 거는 제어가 전부 무력화되므로, "ALB는 오직 CloudFront에서 온 요청만 받는다"를 세 겹으로 강제합니다.
- 1.CloudFront가 ALB에 HTTP:80으로 붙습니다. 인증서 관리가 사라지는 게 첫 이점이고, 뷰어와 CloudFront 사이는 어차피 ACM 인증서로 HTTPS이므로 공인망 구간 암호화는 유지됩니다. CloudFront와 ALB 사이는 AWS 백본 내부 구간입니다.
- 2.ALB의 보안그룹이 인바운드 80을 CloudFront 관리형 프리픽스 리스트(origin-facing IP 대역)에서만 허용합니다. AWS가 CloudFront 오리진 대역을 관리형 목록으로 제공하므로 IP를 손으로 관리할 일이 없습니다. 이 목록 밖에서 오는 접속은 TCP 레벨에서 끊깁니다.
- 3.프리픽스 리스트는 "어떤 CloudFront"인지까지는 구분하지 못합니다. 남이 자기 CloudFront 배포의 오리진으로 우리 ALB를 지정하면 2번을 통과합니다. 그래서 CloudFront 오리진 설정에 커스텀 헤더 X-Origin-Verify(시크릿 값)를 넣고, ALB 리스너 규칙이 이 헤더 값을 AND 조건으로 검사합니다. 헤더가 없거나 틀리면 기본 규칙의 404 고정 응답으로 떨어집니다.
리스너 규칙은 호스트 헤더 기반 라우팅도 겸합니다. plick.co.kr이면 웹 대상 그룹, m.plick.co.kr이면 모바일 대상 그룹으로 보냅니다. 앞서 CloudFront의 오리진 요청 정책을 AllViewer로 둔 이유가 이것입니다. Host를 전달하지 않으면 ALB가 어느 앱으로 보낼지 판단할 근거가 사라집니다.
컴퓨트: 대상 그룹, 보안그룹, 그리고 cattle로서의 EC2
대상 그룹은 앱당 하나입니다(web 3000, mobile 3001). 둘 다 헬스체크 경로가 /api/health이고, 등록 취소 지연(deregistration delay)을 기본 300초에서 30초로 줄였습니다.
ALB는 대상을 뺄 때 진행 중 요청이 없어도 이 시간을 다 채우고서야 드레이닝을 끝내는데, Blue/Green의 Blue 제거 단계가 배포마다 이 시간을 그대로 먹습니다. CloudFront의 오리진 응답 타임아웃이 30초라 그보다 오래 사는 요청은 어차피 끊기므로, 30초면 이론상 최장 요청까지 덮으면서 배포 시간을 분 단위로 줄여 줍니다.
인스턴스 보안그룹은 인바운드가 단 한 줄입니다. TCP 3000-3001을, 소스를 IP 대역이 아니라 퍼블릭 ALB의 보안그룹으로 지정해 허용합니다.
보안그룹을 소스로 쓰면 "그 보안그룹을 단 리소스에서 오는 트래픽"이라는 의미가 되어, ALB 노드의 IP가 바뀌든 늘어나든 규칙을 고칠 일이 없습니다. 나가는 방향으로는 내부 ALB의 보안그룹이 프론트 인스턴스 보안그룹을 소스로 허용해서, 서버 컴포넌트의 데이터 fetch가 내부 ALB를 거쳐 백엔드로 갑니다. 프론트 EC2를 기점으로 인바운드는 ALB에서만, 아웃바운드 API 호출은 내부 ALB로만 흐르는 좁은 길이 됩니다.
EC2는 Launch Template으로 태어납니다. Ubuntu 24.04 x86_64에 t3.small, 30GB gp3이고 키 페어는 없습니다. 핵심은 user data입니다.
첫 부팅 때 Node 22와 pm2, aws CLI를 설치하고 앱 루트 디렉터리(/srv/plick)를 만들어 소유권을 맞춘 뒤, 맨 마지막에 CodeDeploy 에이전트를 설치합니다.
에이전트를 마지막에 두는 순서가 의도적입니다. 에이전트는 설치되는 순간부터 배포를 받을 수 있는데, 배포 훅이 필요로 하는 디렉터리와 CLI가 그보다 늦게 준비되면 배포가 실패합니다..
이 템플릿 덕에 서버 셋업이 전부 코드가 됩니다. 인스턴스에 손으로 뭔가를 깔거나 고치는 일이 없고, 남기고 싶은 변경은 반드시 템플릿 새 버전이나 배포 훅으로 들어갑니다.
Auto Scaling Group은 이 템플릿의 Default 버전으로 두 가용영역에 걸쳐 인스턴스를 유지합니다. Desired 2, Min 2, Max 4입니다. 두 대를 두 AZ에 나눠 두므로 인스턴스 한 대나 AZ 하나가 죽어도 서비스가 유지됩니다. 상태 확인은 ELB가 아니라 EC2 기준입니다.
갓 태어난 인스턴스에는 아직 앱이 없어서 ELB 헬스체크를 반드시 실패하는데, ELB 기준으로 두면 ASG가 "비정상이네" 하고 인스턴스를 죽이고 다시 만들기를 무한 반복합니다.
앱은 CodeDeploy가 나중에 얹는 구조라, ASG는 인스턴스 생존만 보고 서비스 정상 여부는 ALB의 대상 그룹 헬스체크가 따로 판단하게 역할을 나눴습니다.
인스턴스 한 대가 web(:3000)과 mobile(:3001) 두 Next.js 서버를 pm2로 같이 띄웁니다. 두 앱의 트래픽 규모가 아직 앱별 인스턴스를 나눌 수준이 아니고, 한 인스턴스가 두 대상 그룹에 동시에 등록되는 구성으로 충분합니다.(이 선택은 배포 단위에도 영향을 주는데, 아래에서 다시 나옵니다.)
설정 관리: Parameter Store가 .env의 단일 출처입니다
ASG 환경에서 인스턴스는 수시로 태어나고 죽으므로, 서버에 .env 파일을 손으로 만들어 두는 방식은 성립하지 않습니다.
런타임 환경변수는 SSM Parameter Store의 SecureString(/plick/frontend/web/prod/env, /plick/frontend/mobile/prod/env)에 .env 파일 내용 통째로 들어 있고, 배포 때마다 훅이 내려받아 .env를 새로 만듭니다. 값을 바꾸고 싶으면 파라미터를 수정하고 재배포하면 끝입니다. 서버에 들어갈 일이 없습니다.
환경변수 중 API_BASE_URL은 읽히는 시점이 둘이라 주의가 필요한 값입니다. 클라이언트 사이드 fetch가 쓰는 /be 프록시의 목적지는 빌드 시점에 산출물에 굳고(GitHub 환경 시크릿), 서버 컴포넌트 fetch는 실행 시점에 .env(Parameter Store)를 읽습니다. 그래서 백엔드 주소가 바뀌면 시크릿과 파라미터 양쪽을 고치고 재배포해야 합니다. NEXT_PUBLIC_ 계열(사이트 대표 URL 등)은 순수 빌드 타임 값이라 워크플로 파일의 분기 상수로 관리합니다.
IAM: 역할 세 개가 배포 파이프라인의 신뢰 경계를 만듭니다
이 구조에는 프론트 몫의 IAM 역할이 정확히 세 개 있고, 각각 파이프라인의 다른 주체가 씁니다. 환경별로 분리되어 실제로는 여섯 개입니다.
첫째, GitHub Actions용 OIDC 역할입니다.
워크플로 러너에는 AWS 액세스 키가 전혀 없습니다. 대신 GitHub이 발급하는 OIDC 토큰으로 sts:AssumeRoleWithWebIdentity를 호출해 단기 자격 증명을 받습니다. 역할의 신뢰 정책이 토큰의 sub 클레임을 검사하는데, 값을 repo:big-cute-team/plick-frontend:environment:prod로 고정했습니다.
우리 리포의, GitHub Environments에서 prod 환경을 선언한 잡만 이 역할을 얻을 수 있다는 뜻입니다. 잡이 environment를 선언하면 토큰의 sub가 브랜치 형태가 아니라 environment 형태로 나오기 때문에, 환경 단위 신뢰 경계가 브랜치 보호와 별개로 하나 더 생깁니다.
권한 정책은 배포에 필요한 딱 세 가지입니다. 배포 버킷의 자기 환경 접두사에 대한 s3:PutObject, CodeDeploy의 자기 애플리케이션과 배포 그룹에 대한 배포 생성·조회, 정적 버킷에 대한 PutObject·ListBucket. dev 잡이 prod 번들 자리에 쓰거나 prod 배포를 만들 방법이 권한 수준에서 없습니다.
둘째, EC2 인스턴스 역할입니다.
인스턴스 프로파일로 인스턴스에 붙어, 그 위에서 도는 에이전트와 배포 훅이 씁니다. 관리형 정책 AmazonSSMManagedInstanceCore(SSM 세션·에이전트 통신)와 AmazonEC2RoleforAWSCodeDeploy(에이전트가 S3에서 번들을 내려받는 읽기)에, 인라인으로 Parameter Store 읽기를 얹었습니다.
이 인라인 정책의 Resource가 parameter/plick/frontend/*/prod/env로 좁혀져 있어서 prod 인스턴스는 prod 파라미터만 읽을 수 있습니다. 시크릿 복호화는 SecureString의 기본 aws/ssm KMS 키를 쓰므로 별도 키 권한 없이 ssm:GetParameter의 with-decryption으로 끝납니다.
셋째, CodeDeploy 서비스 역할입니다.
Blue/Green에서 CodeDeploy는 ASG를 복제하고 인스턴스를 만들고 지우는, 꽤 힘이 센 오케스트레이션을 합니다. 그 힘을 우리 계정에서 행사할 권한이 이 역할입니다.
AWSCodeDeployRole과 AmazonEC2FullAccess에 더해, 인라인으로 iam:PassRole을 인스턴스 역할 하나로 좁혀 허용합니다.
PassRole은 "새로 만드는 리소스에 이 역할을 붙여도 된다"는 권한인데, 이게 없으면 CodeDeploy가 Green 인스턴스에 인스턴스 프로파일을 달아 주지 못해 기동이 조용히 실패하고, 반대로 넓게 열면 CodeDeploy를 통해 임의의 역할을 단 인스턴스를 만들 수 있게 되므로 반드시 대상을 좁혀야 하는 권한입니다.
러너는 "번들을 올리고 배포를 시작하는" 것까지만, CodeDeploy는 "인스턴스 세트를 갈아 끼우는" 것까지만, 인스턴스는 "자기 번들과 자기 설정을 읽는" 것까지만 할 수 있습니다. 어느 한 조각이 탈취되어도 할 수 있는 일이 그 조각의 반경을 넘지 못합니다.
CD 흐름: 푸시에서 트래픽 전환까지
배포 명세는 전부 리포지토리 안에 있습니다.
워크플로(deploy.yml), appspec.yml, 훅 스크립트 다섯 개이고, 콘솔에서 손으로 하는 배포 절차는 없습니다.
main에 코드가 푸시되면 다음이 순서대로 일어납니다. 문서만 바뀐 푸시는 paths-ignore로 배포를 건너뜁니다. 산출물이 같은데 인스턴스를 통째로 교체하는 낭비를 막기 위해서입니다.
1단계, 빌드. 러너가 pnpm으로 web과 mobile을 각각 빌드합니다. 러너가 ubuntu x86_64인 것과 Launch Template의 AMI가 x86_64인 것은 세트입니다. 산출물에 sharp 같은 플랫폼 종속 네이티브 바이너리가 들어가므로 빌드 환경과 실행 환경의 아키텍처가 일치해야 합니다. Next의 standalone 산출물에는 public/과 .next/static/이 빠져 있어서(CDN 배포 전제) 이 둘을 채워 넣고 앱별 tar.gz로 묶습니다.
2단계, 번들 조립. appspec.yml과 훅 스크립트, 두 tar.gz를 한 디렉터리에 모아 bundle.zip 하나로 만듭니다. 배포 단위가 "앱별 2건"이 아니라 "두 앱을 담은 1건"인 이유는 컴퓨트 구성에서 옵니다. Blue/Green은 인스턴스를 통째로 교체하는데, 한 인스턴스에 두 앱이 같이 사는 구조에서 앱별로 배포를 따로 만들면 두 배포가 같은 ASG를 서로 복제하고 종료하며 싸웁니다. 배포 그룹 하나, 배포 한 번, 검증은 두 포트 모두가 맞는 단위입니다.
3단계, 업로드와 배포 생성. OIDC로 역할을 빌린 러너가 bundle.zip을 s3://plick-deploy/frontend/prod/<커밋sha>/에 올리고, 정적 자산을 정적 버킷에 sync한 뒤, aws deploy create-deployment로 배포를 만듭니다. 정적 업로드가 배포 생성보다 먼저인 것도 순서가 의도된 부분입니다. 트래픽이 신세대로 넘어가는 순간부터 신세대 HTML이 나가는데, 그 HTML이 참조하는 청크가 아직 S3에 없으면 그 구간이 통째로 404이기 때문입니다. 러너는 aws deploy wait deployment-successful로 결과를 기다리고, 실패로 끝나면 잡이 빨간불이 됩니다.
4단계, CodeDeploy의 Blue/Green. 여기부터는 CodeDeploy가 서비스 역할로 오케스트레이션합니다.
- 1.현재 서비스 중인 ASG(Blue)를 복제해 같은 크기의 Green 인스턴스를 새로 띄웁니다. Green은 Launch Template의 user data로 밑바닥부터 셋업됩니다
- 2.Green의 에이전트가 S3에서 번들을 내려받고 appspec의 훅을 순서대로 실행합니다. ApplicationStop(새 인스턴스라 보통 no-op) → BeforeInstall(앱 디렉터리 초기화) → 파일 복사 → AfterInstall(tar 해제, Parameter Store에서 .env 생성) → ApplicationStart(.env를
set -a로 소싱해 pm2 기동) → ValidateService. 훅은 appspec의runas: ubuntu로 실행되어 root와 앱 유저가 꼬이지 않습니다 - 3.ValidateService가 게이트입니다. 3000과 3001의
/api/health가 둘 다 200을 줄 때까지 최대 60초 폴링하고, 하나라도 실패하면 exit 1로 배포 전체를 Failed로 만듭니다. 이 시점의 Green은 아직 트래픽을 받은 적이 없으므로, 실패해도 사용자에게는 아무 일도 없습니다. Blue가 그대로 서비스 중이기 때문입니다. 롤백 스크립트가 따로 없는 이유가 이것입니다. 검증 전에는 트래픽을 옮기지 않는다는 순서 자체가 롤백을 대체합니다 - 4.검증을 통과하면 Green을 두 대상 그룹에 등록하고 Blue를 등록 취소합니다. 드레이닝(30초)이 끝나면 트래픽은 전부 Green입니다
- 5.Blue 인스턴스는 5분 유예 후 종료합니다. 전환 직후 이상을 발견했을 때 살아 있는 Blue로 되돌릴 시간을 벌어 두는 완충입니다
되돌리기가 필요하면 이전 커밋 sha의 번들이 S3에 있으므로(수명 주기 7일) 그 리비전으로 배포를 한 번 더 만들면 됩니다. 롤백도 그냥 또 한 번의 Blue/Green입니다. 앞으로 굴리는 것과 되돌리는 것의 절차가 같다는 게 이 구조의 운영을 단순하게 만듭니다.
환경 분리: 같은 구조 두 벌과 GitHub Environments
dev와 prod는 VPC부터 CloudFront까지 완전히 동형입니다. 갈리는 것은 값뿐입니다.
워크플로 잡이 브랜치에 따라 GitHub Environments의 dev 또는 prod를 선언하면, 그 환경의 시크릿(API_BASE_URL, 배포 역할 ARN)이 잡에 주입됩니다.
CodeDeploy 애플리케이션 이름이나 정적 버킷, 사이트 URL처럼 비밀이 아닌 환경별 값은 워크플로 파일 안의 브랜치 분기 상수로 두었습니다. 값이 diff에 그대로 보여야 리뷰에서 실수를 잡을 수 있기 때문입니다.
배포 훅은 CodeDeploy가 넣어 주는 DEPLOYMENT_GROUP_NAME 환경변수의 접미사로 자기 환경을 판별해 맞는 파라미터 경로를 읽습니다. 같은 bundle.zip이 어느 환경에 떨어져도 동작하는 이유입니다.
dev 환경은 CloudFront 앞에 WAF를 붙여 팀 IP만 허용하는 상시 잠금 상태로 두었습니다. 개발 중인 화면이 검색엔진이나 외부에 노출되지 않게 하는 가장 싼 방법입니다.(WAF는 별로 안비쌉니다)
지금 구조의 장점
- 1.무중단 배포와 공짜 롤백. 검증이 끝나기 전에는 트래픽이 움직이지 않고, 실패의 기본값이 "아무 일도 일어나지 않음"입니다
- 2.재현성. 서버 셋업(user data), 배포 절차(appspec·훅), 인프라 참조(워크플로 상수)가 전부 코드입니다. 인스턴스가 전멸해도 ASG가 새로 띄우고 배포 한 번이면 복구됩니다
- 3.SPOF 제거. 2AZ에 걸친 ASG와 ALB, 어느 인스턴스가 죽어도 남은 쪽이 받습니다
- 4.좁은 공격 표면. 퍼블릭 IP 없는 인스턴스, SSH 없는 운영(SSM), CloudFront만 받는 ALB, 보안그룹 참조로만 이어지는 트래픽 경로, 환경과 주체 단위로 좁힌 IAM
- 5.키 없는 CI. 장기 액세스 키가 어디에도 저장되지 않고, OIDC 단기 자격 증명이 환경 단위로 발급됩니다
- 6.엣지 성능. 정적 자산은 1년 불변 캐시로 엣지에서 끝나고, 세대 간 404도 구조적으로 없습니다
지금까지 앞선 게시글들을 보면, 인프라 구현이 조금씩 성장했습니다.
처음엔 ec2에 직접 빌드 파일들을 넣는 방식이다가
블루/그린 autoscaling, codedeploy를 도입해 이전 단계의 순간적인 서비스 죽음을 방지했고
cloudfront + s3 를 추가하여 배포시 순간적으로 4개의 서버가 띄어져있는 상태에서 정적 파일을 찾지 못하는 문제를 해결하여서 지금의 구조가 되었습니다.
콘솔에서 손으로 하는 일이 배포 파이프라인에 하나도 남아 있지 않다는 것, 그리고 실패의 기본값이 서비스 무영향이라는 것. 이 두 가지를 성공적으로 유지합니다.